/14.png)
/14.png)
/24.png)
/24.png)
/37.png)
/37.png)
/31.png)
/31.png)
/36.png)
/36.png)
/30.png)
/30.png)


大语言模型训练

痛点
万卡训练 Checkpoint 写入导致长时间停顿。

解法
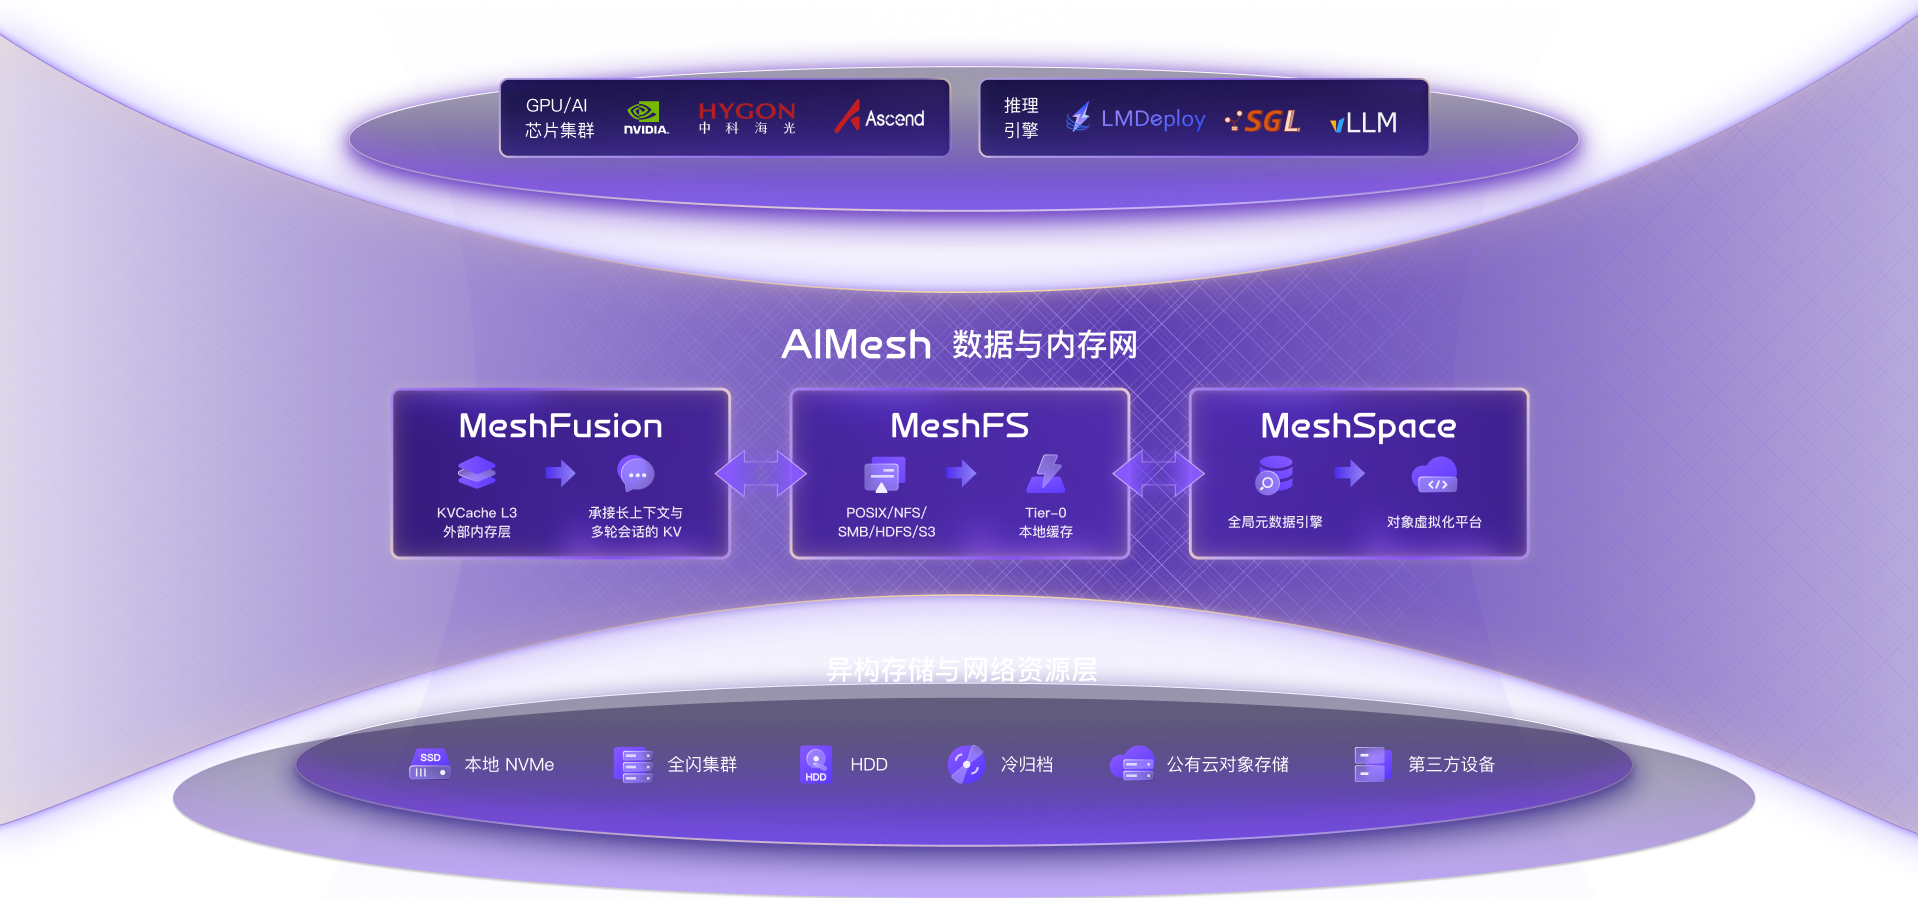
利用 MeshFS 将 Checkpoint 写入时间缩短 90%,GPU 停顿从分钟级压缩至秒级。


Train Faster,喂饱每一张 GPU

让训练不再等盘:
全闪 Shared-Everything 架构 + RDMA,消除单点热点。

多协议融合
原生支持 POSIX、SMB、NFS、S3,数据清洗与训练无需搬迁。

智能分层:
一体化冷热分层,兼顾高性能访问与低成本存储

Infer Deeper,拆掉推理内存墙

KVCache L3 外部内存
将海量 KV Cache 卸载至高性能 NVMe 池,成本仅为 HBM/DRAM 的 1/100。

算存融合架构
消除网络瓶颈,性能可达 DRAM 的 90% 以上,稳定支撑超长上下文。
生态无缝兼容
即插即用对接 vLLM, SGLang, LMDeploy 等主流推理框架,模型无需修改。
Store Smarter,夷平数据

全局统一视图
通过全局命名空间,将跨地域、跨云的异构存储虚拟化为单一逻辑数据湖。
智能数据流动
基于访问热度,数据在高性能层(MeshFS)与低成本层(HDD/Cloud)间自动流转。

无限弹性扩展
纳管第三方存储与公有云对象,支撑 EB 级 AI 资产管理。

Train Faster,喂饱每一张 GPU
让训练不再等盘:
全闪 Shared-Everything 架构 + RDMA,消除单点热点。
多协议融合
原生支持 POSIX、SMB、NFS、S3,数据清洗与训练无需搬迁。
智能分层:
一体化冷热分层,兼顾高性能访问与低成本存储

Infer Deeper,拆掉推理内存墙
KVCache L3 外部内存
将海量 KV Cache 卸载至高性能 NVMe 池,成本仅为 HBM/DRAM 的 1/100。
算存融合架构
消除网络瓶颈,性能可达 DRAM 的 90% 以上,稳定支撑超长上下文。
生态无缝兼容
即插即用对接 vLLM, SGLang, LMDeploy 等主流推理框架,模型无需修改。
Store Smarter,夷平数据
全局统一视图
通过全局命名空间,将跨地域、跨云的异构存储虚拟化为单一逻辑数据湖。
智能数据流动
基于访问热度,数据在高性能层(MeshFS)与低成本层(HDD/Cloud)间自动流转。
无限弹性扩展
纳管第三方存储与公有云对象,支撑 EB 级 AI 资产管理。

痛点
万卡训练 Checkpoint 写入导致长时间停顿。
解法
利用 MeshFS 将 Checkpoint 写入时间缩短 90%,GPU 停顿从分钟级压缩至秒级。
痛点
百万级 Token 上下文对 HBM 造成巨大压力。
解法
MeshFusion 稳定支撑长窗口,成本大幅降低。TTFT 仍优于纯 DRAM 方案。
痛点
海量小文件导入、数据清洗、训练间反复拷贝。
解法
实现从采集到训练的全流程数据零拷贝,极大加速模型迭代。
痛点
非结构化数据规模持续增长,数据对象与描述信息分散,难以形成可治理、可复用的生产级数据集
解法
MeshSpace 以统一数据空间承载多模态对象,为多模态数据的检索、分析、治理及AI数据集持续消费提供一致入口